原始 Transformer:Encoder-Decoder 架构
2017 年 “Attention Is All You Need” 论文提出的原始 Transformer 由两大部分组成。
Encoder:读取输入序列,生成上下文表示。每层包含一个 Self-Attention 和一个 FFN(前馈神经网络),所有 token 可以互相关注(双向注意力)
Decoder:基于 Encoder 的输出,自回归地生成目标序列。每层包含一个带因果掩码的 Self-Attention(只能看到已生成的 token)、一个 Cross-Attention(关注 Encoder 输出)和一个 FFN
在 Self-Attention 中,序列里的每个 token 都同时扮演这QKV:它既是提问者(生成 Q),也是被查询的索引(生成 K),还是信息的提供者(生成 V)。通过 Q 和 K 的匹配来计算”注意力权重”,再用这些权重对 V 做加权求和,就完成了信息的聚合。复杂度是O(n^2)
的显存瓶颈直接催生了 FlashAttention,复杂度变为O(n)。这正是”Memory-aware”优化的核心思想。
三种注意力
- Encoder Self-Attention:Encoder 层里,QKV 都来自 encoder 输入,token 和 token 互相看。
- Decoder Masked Self-Attention(掩码自注意力):Decoder 第一层,QKV 都来自 decoder 当前已经生成的序列,加 mask,预测第 i 个 token 的时候,看不到未来还没生成的 token。
- Cross-Attention(交叉注意力):Decoder 第二层,Decoder 生成每个词的时候,去 “看一眼 Encoder 里的源句子信息”。
- Q:来自 Decoder 上一层输出(当前生成的 token)
- K、V:来自 Encoder 的最终输出(上下文 / 源序列)
KV Cache 就是为了加速自回归:前面已经算过的 token 的 K、V 缓存起来,不用每次从头重新计算,不然生成会非常慢。
标准 Transformer Decoder 一层顺序:
输入 → Masked Self-Attention → Add+Norm → Cross-Attention → Add+Norm → FFN → Add+Norm → 输出
当前大模型的主流:Decoder-only 架构
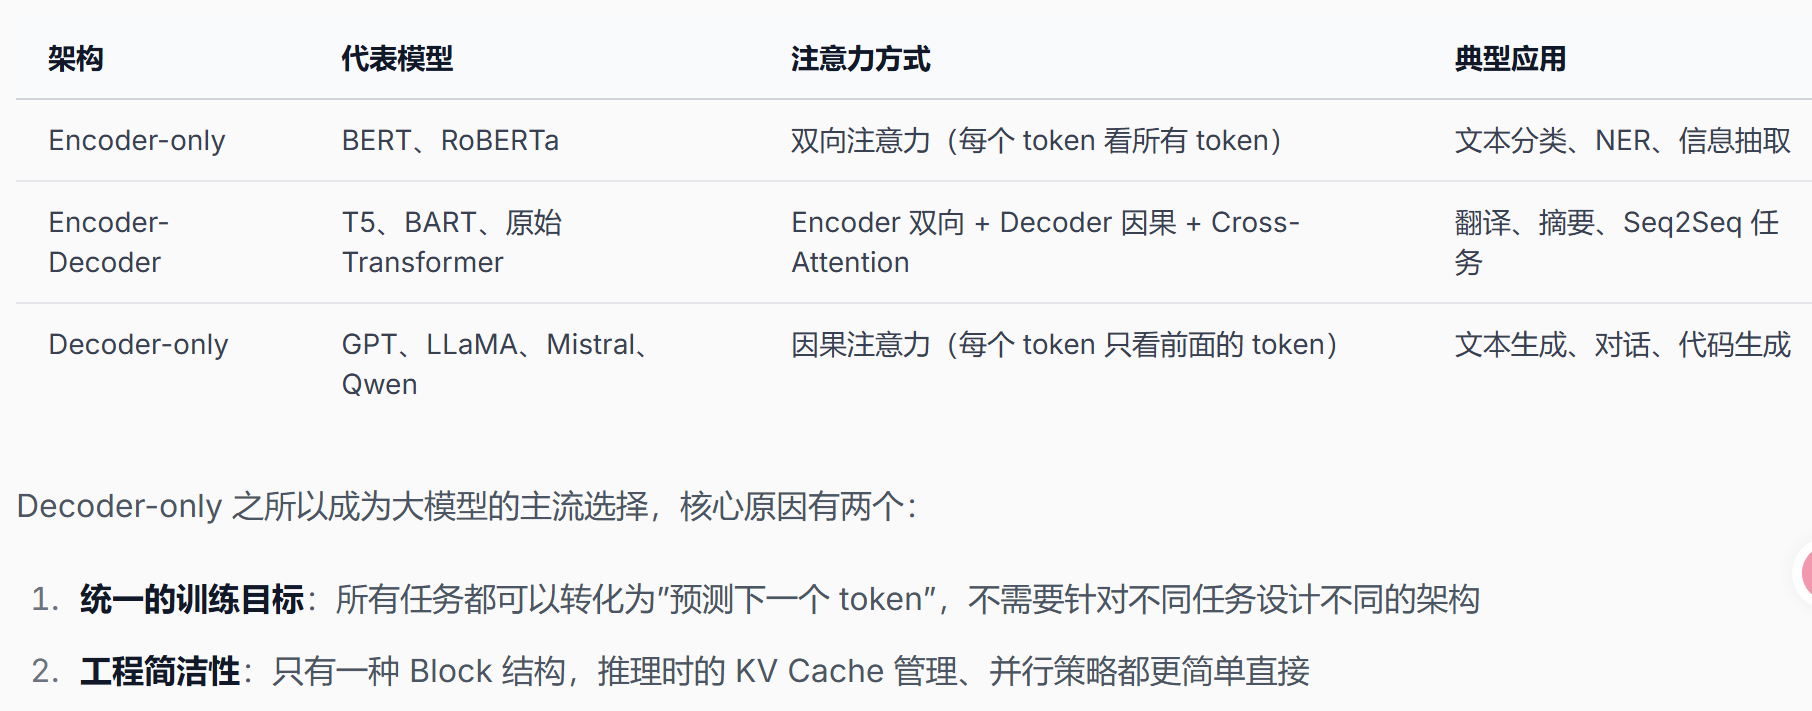
当前几乎所有主流大语言模型——GPT、LLaMA、Mistral、Qwen、DeepSeek——都采用 Decoder-only 架构,砍掉了 Encoder 和 Cross-Attention,只保留带因果掩码的 Masked Self-Attention。
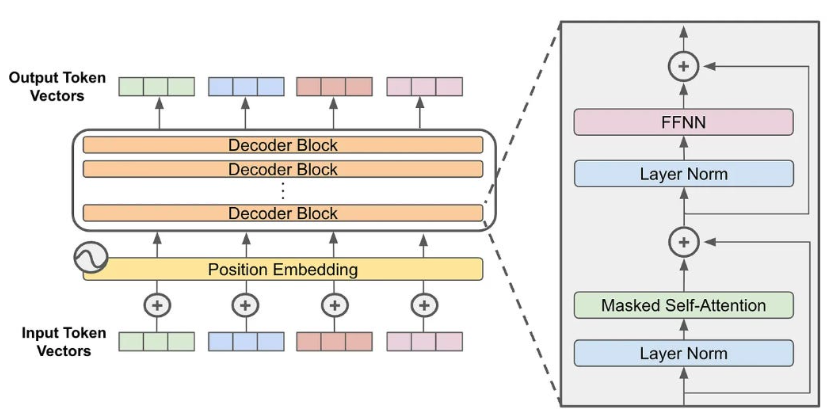
整个模型的核心就是中间那 N 层 Decoder Block 的反复堆叠。每个 Block 的结构完全相同,包含两个子模块:
Masked Self-Attention:让每个 token 从前面的 token 中聚合信息 FFN:对每个 token 的信息做独立的非线性变换
Pre-Norm vs Post-Norm
Norm = LayerNorm;Add = 残差连接 residual add 两者的本质区别:LayerNorm 放在残差分支的里面还是外面
Post-Norm 顺序:子层计算 → Add 残差 → LayerNorm
残差输出经过 Norm 才传给下一层,深层网络容易梯度爆炸,对学习率、初始化很敏感;残差通路没有归一化,随着层数堆叠,数值会累积放大
Pre-Norm 顺序:LayerNorm → SubLayer (MHA/FFN) → Add 残差
- Norm 在子层输入前面
- 残差直连支路不经过任何 Norm,直接加到子层输出
- 梯度更稳定,可以堆很深(大模型都用这个)
- 训练更稳,调参门槛更低
计算过程:从输入到输出的完整流程
第一步:线性投影生成 Q、K、V 第二步:计算注意力分数 第三步:缩放(Scale) 第四步:Softmax 归一化 第五步:加权求和 第六步:输出投影
FFN
Attention 负责”信息交互”——让 token 之间互相传递信息。但仅靠信息交互还不够,模型还需要对每个 token 的信息做”深度加工”。这就是前馈网络(Feed-Forward Network,FFN)的工作。
打个比方:Attention 像一场圆桌会议,大家互相交换意见;FFN 则是会后每个人回到自己工位上,独立消化吸收这些信息并形成自己的判断。FFN 对每个 token 独立地做非线性变换,不涉及 token 之间的交互。
位置编码
语言显然是有顺序的!“猫追狗”和”狗追猫”意思完全不同。所以我们必须想办法把位置信息注入到 Transformer 中。
Sinusoidal 位置编码:原始论文方案
“Attention Is All You Need” 论文提出了一种优雅的方案:用不同频率的正弦/余弦函数为每个位置生成一个独特的编码向量,直接加到 token 的 embedding 上。
这就像用”年-月-日-时-分-秒”来编码时间——“年”变化最慢但能区分大时间跨度,“秒”变化最快但只能区分小时间跨度。所有维度组合起来,每个位置就有了唯一的”时间戳”。
局限:位置信息是”加”在 embedding 上的,在深层网络中可能被逐渐稀释,难以有效外推到训练时未见过的长度
RoPE(旋转位置编码):当前大模型的主流选择
目前几乎所有主流大模型(LLaMA、Mistral、Qwen、DeepSeek 等)采用的位置编码方案。核心思想:不在 embedding 层注入位置信息,而是在计算 Attention 时,通过旋转 Q 和 K 向量来编码位置。
LayerNorm 与残差连接
output=x+SubLayer(x),其中 SubLayer 可以是 Attention 层或 FFN 层。 在原始信息基础上,只学习增量