BM25
BM25 是经典搜索引擎(如 Elasticsearch / 电脑本地文件搜索)背后的核心算法。
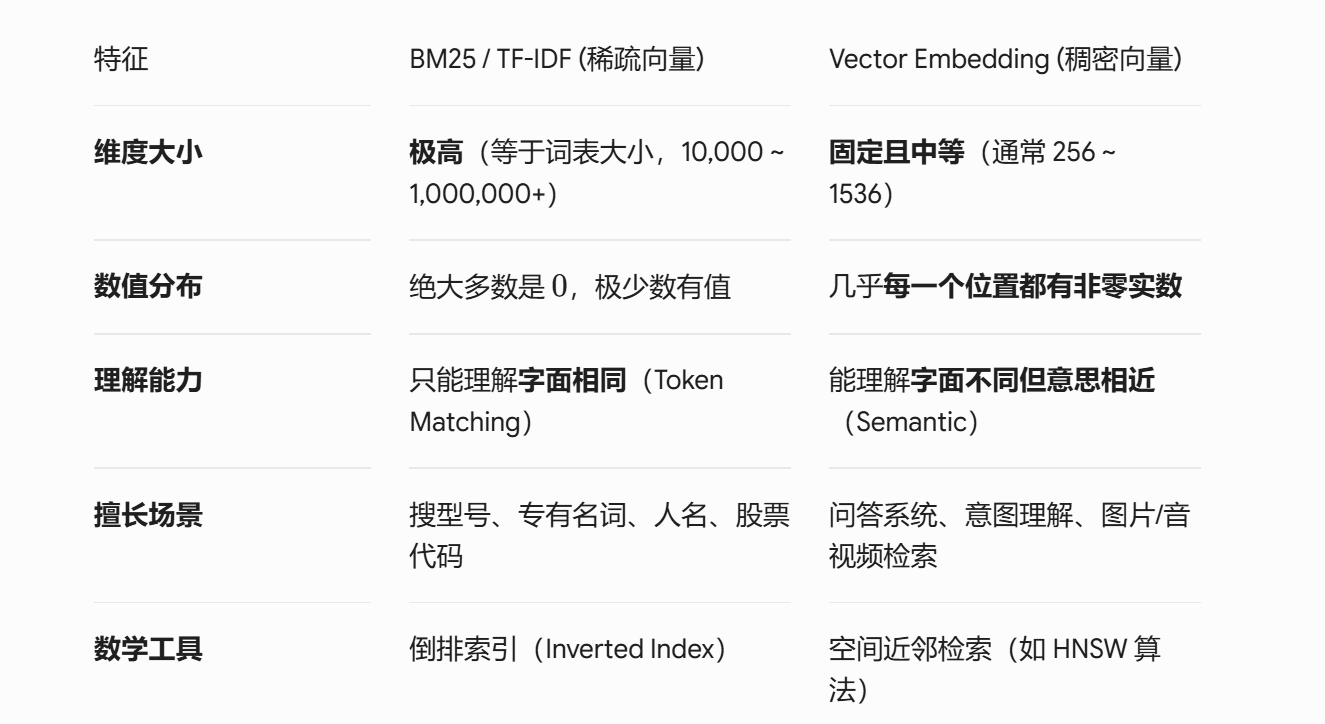
外号: 稀疏向量检索
它的逻辑: 死磕字面,绝对忠诚,不管语义。 你搜什么词,我就去文章里数这个词出现了几次。
它的三大绝招:
-
词频(TF): 词在文章里出现越多,分越高。但有上限(饱和度),出现 100 次和 50 次在它看来差不多。
-
稀缺度(IDF): 如果你搜“我的冰美式”,“我”和“的”到处都是,不值钱;“冰美式”很罕见,谁有“冰美式”谁拿高分。
-
篇幅惩罚: 同样出现 3 次“冰美式”,一篇 50 字的短文肯定比一篇 1 万字的长文更相关。
向量检索
利用深度学习的 Embedding 模型,把文字、图片变成一串由数字组成的坐标(向量)。
它的外号:密集向量检索。
它的逻辑: 不看字面,只懂意思。
它的绝招: 它能听懂潜台词。你搜“提神提气的苦咖啡”,文章里可能一个相同的字都没有,但向量检索能通过“意思接近”,帮你把写有“冰美式”的文章捞出来。
混合检索
BM25 和 向量检索 是两条不同的“捞数据”路径,而混合检索是把两者的优势结合。
那么 BM25、 Embedding分别检索出来的结果,最后怎么处理的
BM25 和 Embedding 分别检索出结果后,由于它们使用的是完全不同的打分体系(BM25 通常是大于 0 的具体分值,受词频和文档长度影响;而 Embedding 通常是 0 - 1 之间的余弦相似度),绝对不能把它们的分数直接相加。这就像把“摄氏度”和“华氏度”直接加在一起一样,没有数学意义。
- RRF(Reciprocal Rank Fusion,倒数排名融合)
系统会计算所有被召回文档的 RRF 得分,然后从高到低重新排序,把最终的总冠军推给用户或大模型。
- Score Normalization(分数归一化加权)
缩放分数(归一化):把 BM25 的分数(可能在 0 - 30 之间)和 Embedding 的分数(通常在 0.5 - 0.9 之间),通过数学公式(如 Min-Max 映射)全部等比例缩放到 0 - 1 的区间内。
加权相加:FinalScore = a*BM25Normalized + (1 - a)*EmbeddingNormalized
如果设置 \alpha = 0.3,就代表 30% 听 BM25 的,70% 听 Embedding 的。
- Cross-Encoder / Reranker(深度学习重排)
粗筛 + 精排
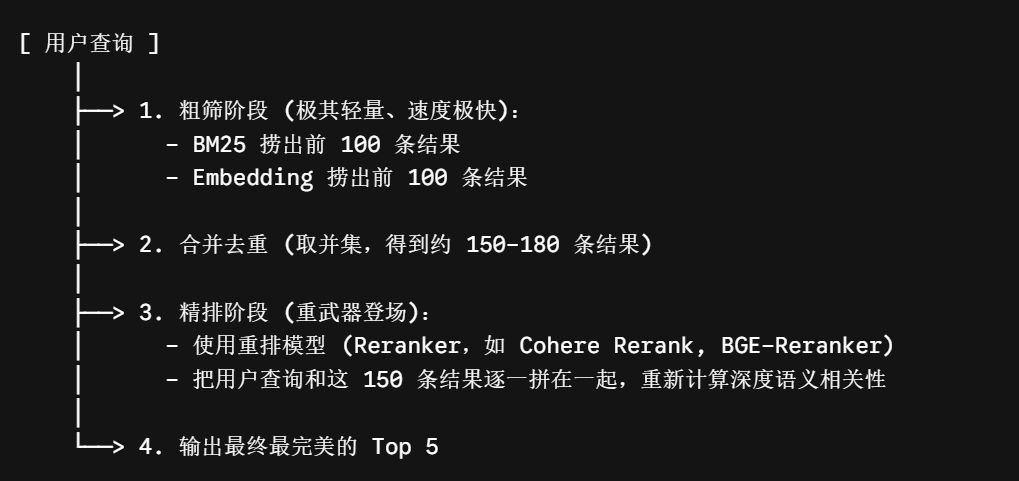
Reranker(Cross-Encoder) 是把 [用户输入 + 文档内容] 作为一个整体同时喂给大模型(Attention 机制全开),让大模型逐字逐句去审视它们到底配不配。它虽然速度慢,但处理少量的(比如 100 条)合并后的数据,准确率会发生质的飞跃。